
Python ملف XML - كيفية القراءة والكتابة والتحليل
 فريق التحرير
⚡ ملخص ذكي
Python تتيح لك معالجة XML قراءة وكتابة وتحليل مستندات XML باستخدام وحدتي minidom وElementTree المدمجتين. تقوم فئة minidom بتحميل ملف في الذاكرة كنموذج كائن المستند (DOM)، بينما توفر ElementTree أداءً أسرع وأكثر كفاءة. Pythonواجهة برمجة تطبيقات شجرة المعلومات.
تتناول الأقسام التالية تحليل وكتابة وقراءة ملفات XML في Python.
ما هو XML؟
يرمز XML إلى لغة التوصيف القابلة للتوسيع. تم تصميمه لتخزين ونقل كميات صغيرة إلى متوسطة من البيانات ويستخدم على نطاق واسع لمشاركة المعلومات المنظمة.
Python تُمكّنك هذه الخاصية من تحليل وتعديل مستندات XML. ولتحليل مستند XML، يجب أن يكون المستند بأكمله موجودًا في الذاكرة. في هذا الدرس، سنرى كيف يمكننا استخدام فئة XML minidom في Python لتحميل وتحليل ملفات XML.
كيفية تحليل XML باستخدام minidom
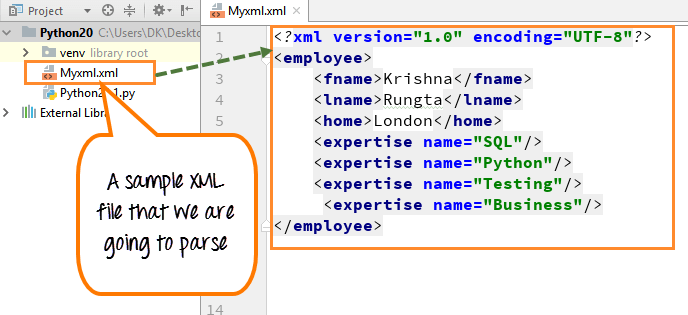
لقد أنشأنا نموذجًا لملف XML وسنقوم بتحليله.
الخطوة 1) إنشاء ملف XML النموذجي
داخل الملف، يمكننا رؤية الاسم الأول واسم العائلة والمنزل ومجال الخبرة (SQL، Python(الاختبار والأعمال).
الخطوة 2) استخدم وظيفة التحليل لتحميل ملف XML وتحليله
بعد تحليل المستند، سنطبع "اسم العقدة" لجذر المستند و"اسم الوسم الأول". يُعدّ كل من اسم الوسم واسم العقدة من الخصائص القياسية لملف XML.
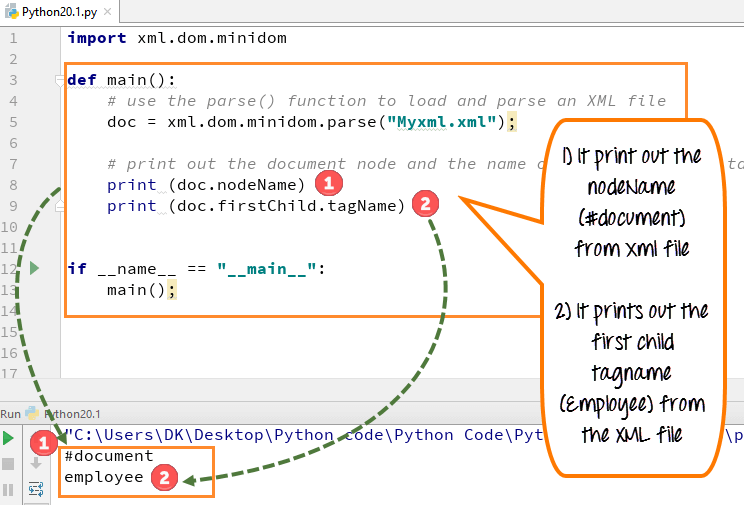
- قم باستيراد وحدة xml.dom.minidom وقم بتحديد الملف الذي يجب تحليله (myxml.xml).
- يحتوي هذا الملف على بعض المعلومات الأساسية عن الموظف مثل الاسم الأول واسم العائلة والمنزل والخبرة وما إلى ذلك.
- نستخدم وظيفة التحليل في XML minidom لتحميل ملف XML وتحليله
- لدينا متغير اسمه doc، ويحصل doc على نتيجة دالة التحليل.
- نريد طباعة اسم العقدة واسم الوسم الفرعي من الملف، لذلك نُعلن عنهما في دالة الطباعة.
- قم بتشغيل الكود - يقوم بطباعة اسم العقدة (#document) من ملف XML واسم العلامة الفرعي الأول (الموظف) من ملف XML
ملاحظات: Nodename و child tagname هما الاسمان أو الخاصيتان القياسيتان لـ XML dom.
الخطوة 3) استدعِ قائمة علامات XML من مستند XML واطبعها
بعد ذلك، يمكننا أيضًا استدعاء قائمة علامات XML من مستند XML وطباعتها. هنا قمنا بطباعة مجموعة من المهارات مثل SQL، Python, الاختبار والأعمال.

- حدد الخبرة المتغيرة التي سنستخرج منهاtracجميع أسماء الخبرات التي يمتلكها الموظف
- استخدم الدالة القياسية dom المسماة "getElementsByTagName"
- سيؤدي هذا إلى الحصول على جميع العناصر المسماة المهارة
- قم بإنشاء حلقة تكرارية على كل علامة من علامات المهارات
- قم بتشغيل الكود - سيعرض قائمة بأربع مهارات
كيفية كتابة عقدة XML
يمكننا إنشاء سمة جديدة باستخدام وظيفة "createElement" ثم إلحاق هذه السمة أو العلامة الجديدة بعلامات XML الموجودة. أضفنا علامة جديدة "BigData" في ملف XML الخاص بنا.
- عليك كتابة التعليمات البرمجية لإضافة السمة الجديدة (BigData) إلى علامة XML الموجودة
- بعد ذلك، عليك طباعة وسم XML مع السمة الجديدة المضافة إلى وسم XML الحالي.
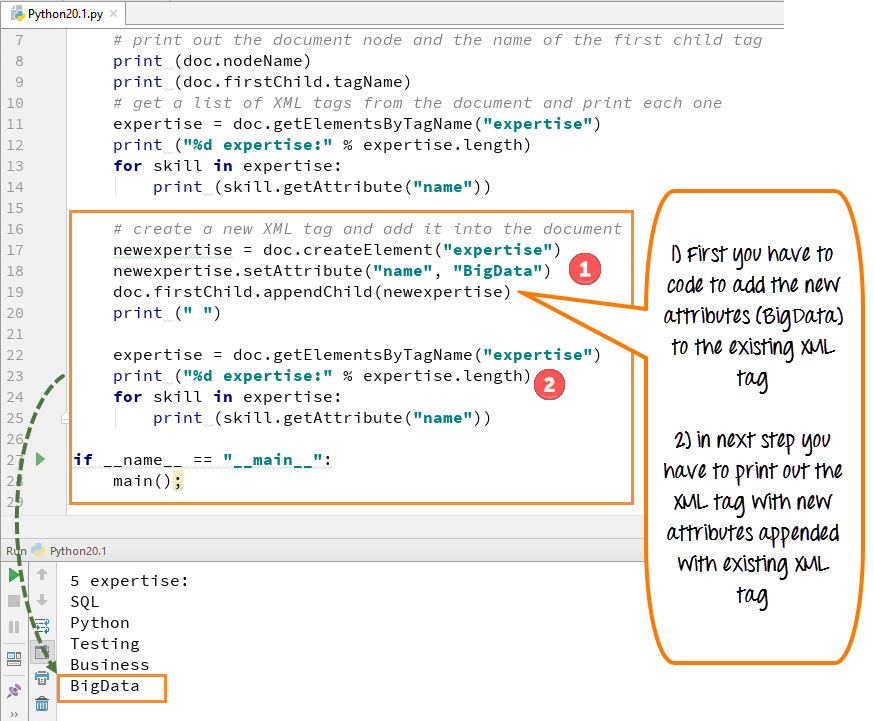
- لإضافة علامة XML جديدة وإضافتها إلى المستند، نستخدم الكود "doc.createElement".
- سيقوم هذا الكود بإنشاء علامة مهارة جديدة لسمتنا الجديدة "البيانات الضخمة".
- أضف علامة المهارة هذه إلى العنصر الفرعي الأول في المستند (الموظف).
- قم بتشغيل الكود - ستظهر العلامة الجديدة "البيانات الضخمة" مع قائمة الخبرات الأخرى
مثال على محلل XML
Python 2 مثال
import xml.dom.minidom

def main():
# use the parse() function to load and parse an XML file
   doc = xml.dom.minidom.parse("Myxml.xml");

# print out the document node and the name of the first child tag
   print doc.nodeName
   print doc.firstChild.tagName

# get a list of XML tags from the document and print each one
   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

#Write a new XML tag and add it into the document
   newexpertise = doc.createElement("expertise")
   newexpertise.setAttribute("name", "BigData")
   doc.firstChild.appendChild(newexpertise)
   print " "

   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

if name == "__main__":
  main();
Python 3 مثال
import xml.dom.minidom

def main():
    # use the parse() function to load and parse an XML file
    doc = xml.dom.minidom.parse("Myxml.xml");

    # print out the document node and the name of the first child tag
    print (doc.nodeName)
    print (doc.firstChild.tagName)
    # get a list of XML tags from the document and print each one
    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

    # Write a new XML tag and add it into the document
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print (" ")

    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

if __name__ == "__main__":
    main();
كيفية تحليل XML باستخدام ElementTree
ElementTree هي واجهة برمجة تطبيقات (API) لمعالجة ملفات XML. تُعد ElementTree طريقة سهلة لمعالجة ملفات XML.
نحن نستخدم مستند XML التالي كبيانات عينة:
<data>
   <items>
      <item name="expertise1">SQL</item>
      <item name="expertise2">Python</item>
   </items>
</data>
قراءة XML باستخدام ElementTree:
يجب علينا أولاً استيراد وحدة xml.etree.ElementTree.
import xml.etree.ElementTree as ET
والآن دعونا نسترجع العنصر الجذر:
root = tree.getroot()
فيما يلي الكود الكامل لقراءة بيانات XML المذكورة أعلاه:
import xml.etree.ElementTree as ET
tree = ET.parse('items.xml')
root = tree.getroot()

# all items data
print('Expertise Data:')

for elem in root:
   for subelem in elem:
      print(subelem.text)
الإخراج:
Expertise Data:
SQL
Python
