
بنية بيانات الكومة: ما هي الكومة؟
 سارة تشين
⚡ ملخص ذكي
بنية بيانات الكومة هي شجرة ثنائية كاملة متخصصة حيث تحافظ كل عقدة أصلية على علاقة ترتيب صارمة مع أبنائها، مما يتيح عمليات الإدخال والحذف اللوغاريتمية وعمليات قائمة الانتظار ذات الأولوية عبر عمليات الفرز والجدولة وأحمال العمل الرسومية.
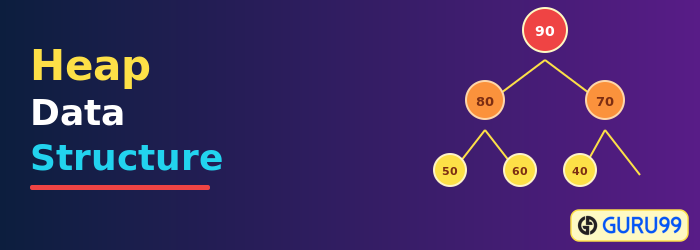
ما هي بنية بيانات الكومة؟
الكومة هي بنية بيانات شجرية متخصصة. تتكون بنية بيانات الكومة من عقدة علوية تُسمى الجذر (الأب). العقدة الثانية هي الابن الأيسر للجذر، بينما العقدة الثالثة هي الابن الأيمن للجذر. تُملأ العقد المتتالية من اليسار إلى اليمين. تتم مقارنة مفتاح العقدة الأب بمفتاح نسلها لضمان الترتيب الصحيح. يسهل تصور الشجرة، حيث يُسمى كل كيان عقدة، ولكل عقدة مفتاح فريد للتعريف.
بعبارات بسيطة، الكومة هي شجرة ثنائية كاملة تحقق خاصية الكومة: كل أصل مرتب بشكل متسق مقابل أبنائه، مما يجعلها مثالية لقوائم الانتظار ذات الأولوية وفرز الكومة.
لماذا تحتاج إلى بنية بيانات الكومة؟
فيما يلي الأسباب الرئيسية لاستخدام الكومة:
- تسمح بنية بيانات الكومة بالحذف والإدراج في وقت لوغاريتمي – O(log2ن).
- تُرتّب البيانات في الشجرة وفق ترتيب مُحدد. وإلى جانب تحديث القيم أو الاستعلام عنها، مثل القيم القصوى أو الدنيا، يستطيع المبرمج إيجاد العلاقات بين الأصل والفرع.
- يمكنك تطبيق مفهوم طراز كائن المستند لمساعدتك على فهم بنية بيانات الكومة بصريًا.
- تدعم الأكوام عمليات قائمة الانتظار ذات الأولوية الفعالة، والتي تعتبر بالغة الأهمية لخوارزميات الرسم البياني مثل أقصر مسار لـ Dijkstra وشجرة الامتداد الأدنى لـ Prim.
أنواع الأكوام
تتضمن بنية بيانات الكومة خوارزميات متنوعة لمعالجة عمليات إدخال وحذف العناصر، بما في ذلك قائمة الانتظار ذات الأولوية، والكومة الثنائية، والكومة ذات الحدين، و نوع كومة.
- طابور الأولوية: إنها عضلات بطنtracبنية بيانات تحتوي على كائنات ذات أولوية. لكل كائن أو عنصر أولوية محددة مسبقًا. لذلك، يحصل الكائن أو العنصر ذو الأولوية الأعلى على الخدمة قبل غيره.
- الكومة الثنائية: تُعدّ الأكوام الثنائية مناسبة لعمليات الكومة البسيطة مثل الحذف والإضافة. وهي التنفيذ الافتراضي لمعظم قوائم الانتظار ذات الأولوية في المكتبات القياسية.
- كومة ذات الحدين: تتكون الكومة الثنائية من سلسلة من مجموعات الأشجار الثنائية التي تشكل الكومة. شجرة الكومة الثنائية ليست شجرة عادية، إذ أنها محددة بدقة. يساوي العدد الإجمالي للعناصر في الشجرة الثنائية دائمًا 2^12.n العقد.
- فرز الكومة: على عكس معظم خوارزميات الفرز، يستخدم فرز الكومة مساحة ثابتة O(1) لعملية الفرز. وهي خوارزمية فرز قائمة على المقارنة، حيث يتم الفرز بترتيب تصاعدي عن طريق تحويل المدخلات أولاً إلى كومة عظمى. ويمكن اعتبار فرز الكومة بمثابة نسخة مطورة من شجرة البحث الثنائية.
عادةً، تستخدم بنية بيانات الكومة استراتيجيتين. بالنسبة للمدخلات 12 – 8 – 4 – 2 و 1:
- كومة صغيرة – أقل قيمة في الأعلى
- أقصى كومة – أعلى قيمة في القمة

كومة صغيرة
في بنية الكومة الدنيا، تكون قيمة العقدة الجذرية إما مساوية أو أصغر من قيمة أبناء تلك العقدة. لذا، فإن جذر الكومة الدنيا يحمل القيمة الدنيا. كما أن الكومة الدنيا عبارة عن شجرة ثنائية كاملة.
بمجرد الحصول على كومة دنيا في الشجرة، تصبح جميع الأوراق مرشحة للحصول على القيمة القصوى. مع ذلك، يجب فحص كل ورقة على حدة للحصول على قيمة كومة قصوى دقيقة.
مثال على كومة الحد الأدنى

في الرسم التخطيطي أعلاه، يمكنك ملاحظة تسلسل واضح من الجذر إلى العقدة الأدنى.
لنفترض أنك تخزن العناصر في المصفوفة Array_N[12, 2, 8, 1, 4]. كما تلاحظ من المصفوفة، فإن العنصر الجذر يخالف أولوية كومة الحد الأدنى. للحفاظ على خاصية كومة الحد الأدنى، عليك إجراء عمليات تحويل كومة الحد الأدنى لتبديل العناصر حتى يتم استيفاء قواعد كومة الحد الأدنى.
أقصى كومة
في بنية كومة القيم القصوى، تحتوي العقدة الأب أو الجذرية على قيمة مساوية أو أكبر من قيمة أبنائها. تحمل هذه العقدة القيمة القصوى. وهي شجرة ثنائية كاملة، لذا يمكنك بناء كومة قيم قصوى من مجموعة من القيم في زمن O(n).
فيما يلي بعض الطرق الشائعة الاستخدام عند تنفيذ Java ماكس هيب:
- يضيف (): يضع عنصرًا جديدًا في كومة. إذا كنت تستخدم مصفوفة، تتم إضافة العناصر في نهاية المصفوفة، بينما في الشجرة الثنائية، تتم إضافة العناصر من الأعلى إلى الأسفل ثم من اليسار إلى اليمين.
- يزيل (): تتيح لك هذه الطريقة إزالة العنصر الأول من قائمة المصفوفة. ولأن العنصر الذي تمت ترقيته حديثًا لم يعد الأكبر، فإن طريقة Sift-Down تقوم دائمًا بنقله إلى موقعه الجديد.
- Sift-Down (): تقوم هذه الطريقة بمقارنة الكائن الجذر بأبنائه ثم تدفع العقدة التي تم نقلها إلى موضعها الصحيح.
- Sift-Up (): إذا استخدمتَ طريقة المصفوفة لإضافة عنصر جديد إلى مصفوفة، فإن طريقة Sift-Up تساعد العنصر المُضاف حديثًا على الانتقال إلى موضعه الصحيح. تتم مقارنة العنصر الجديد أولًا بالعنصر الأصل له عن طريق محاكاة بنية بيانات الشجرة.
قم بتطبيق الصيغة Parent_Index = Child_Index / 2. استمر في القيام بذلك حتى يصبح العنصر الأقصى في مقدمة المصفوفة.
الكومة الأساسية Operaستعقد
للعثور على أعلى وأدنى القيم في مجموعة بيانات، تحتاج إلى بعض عمليات الذاكرة الأساسية مثل البحث والإضافة والحذف. ولأن العناصر تتغير باستمرار، يجب أن تعرف كيفية القيام بما يلي:
- - ابحث عن عنصر في الكومة.
- إدراج - إضافة طفل جديد إلى الكومة.
- حذف - حذف عقدة من الكومة.
إنشاء أكوام
تُعرف عملية إنشاء الأكوام باسم إنشاء الأكوام. عند إعطاء قائمة من المفاتيح، يقوم المبرمج بإنشاء كومة فارغة ثم يُدخل المفاتيح الأخرى واحدًا تلو الآخر باستخدام عمليات الكومة الأساسية.
لنبدأ الآن ببناء كومة دنيا باستخدام طريقة ويليام عن طريق إدخال القيم 12، 2، 8، 1، و4. يمكنك بناء الكومة التي تحتوي على n عنصرًا عن طريق البدء بكومة فارغة ثم ملؤها تباعًا بعناصر أخرى باستخدام وقت O(n log n).

- هيبيفاي: روتين إدخال يساعد في إدخال العناصر في كومة مع الحفاظ على خاصية الكومة.
على سبيل المثال، تتحقق عملية بناء كومة قصوى من أن قيمة العنصر الأب أكبر من قيمة العنصر الابن. ويمكن بعد ذلك فرز العناصر باستخدام طرق مثل التبديل.ping.
- دمج: عندما يكون لديك مجموعتان من البيانات لدمجهما في مجموعة واحدة، استخدم عملية الدمج لجمع القيم من المجموعتين معًا. تبقى المجموعات الأصلية محفوظة.
فحص أكوام
يشير فحص الأكوام إلى التحقق من عدد العناصر في بنية بيانات الكومة والتحقق مما إذا كانت الكومة فارغة.
من المهم فحص أكوام البيانات أثناء فرز العناصر أو إضافتها إلى قائمة الانتظار. من الضروري التحقق من وجود عناصر للمعالجة باستخدام الدالة IsEmpty(). يساعد حجم الكومة في تحديد جذور الكومة القصوى أو الكومة الدنيا، لذا يجب معرفة عدد العناصر التي تتبع خاصية الكومة.
- المقاس – تُعيد هذه الدالة حجم أو طول الكومة. وتُخبرك بعدد العناصر المخزنة بترتيب مُرتب.
- Is-Empty – تُرجع القيمة TRUE إذا كانت الكومة فارغة، وإلا فإنها تُرجع القيمة FALSE.
هنا، تقوم بطباعة جميع العناصر الموجودة في ملف الأولويةس حلقة ثم التحقق من أن الأولوية Q ليست فارغة.
//print head the head values
       While (!priorityQ.isEmpty()) {
        System.out.print(priorityQ.poll()+" ");
استخدامات بنية بيانات الكومة
تُعد بنية بيانات الكومة مفيدة في العديد من تطبيقات البرمجة في الحياة الواقعية، مثل:
- يساعد في تصفية الرسائل غير المرغوب فيها.
- تطبيق خوارزميات الرسوم البيانية مثل خوارزمية ديكسترا وخوارزمية بريم.
- Operaموازنة أحمال النظام وضغط البيانات.
- إيجاد إحصائيات الترتيب مثل أصغر عنصر في الرتبة k.
- تطبيق قوائم الانتظار ذات الأولوية حيث يمكنك البحث عن العناصر في قائمة في وقت لوغاريتمي.
- تُستخدم بنية بيانات الكومة أيضًا للفرز من خلال فرز الكومة.
- محاكاة العملاء في طابور الانتظار.
- معالجة المقاطعات في نظام التشغيل.
- في ترميز هوفمان لضغط البيانات.
- دعم البحث الأفضل أولاً وخوارزميات A* في تخطيط مسار الذكاء الاصطناعي.
خصائص قائمة انتظار أولوية الكومة
تصف الخصائص التالية كيفية عمل قائمة الانتظار ذات الأولوية المبنية على كومة:
- في أكوام الأولويات، تتم مقارنة عناصر البيانات الموجودة في القائمة ببعضها البعض لتحديد العنصر الأصغر أو الأكبر.
- يتم وضع عنصر في قائمة الانتظار ثم إزالته حسب ترتيب الأولوية.
- كل عنصر في قائمة الانتظار ذات الأولوية له رقم فريد مرتبط به ويحدده كأولوية.
- عند الخروج من قائمة الانتظار ذات الأولوية، يخرج العنصر ذو الأولوية الأعلى أولاً.
خطوات تنفيذ قائمة انتظار أولوية الكومة في Java
القسم التالي ينتقل إلى موضوع ملموس Java تطبيق يحول هذه القواعد إلى كود برمجي فعال.

فرز الكومة في Java مع Code مثال
import java.util.Arrays;
public class HeapSort {
    public static void main(String[] args) {
        int[] arr = {5, 9, 3, 1, 8, 6};
        // Sort the array using heap sort
        heapSort(arr);
        // Print the sorted array
        System.out.println(Arrays.toString(arr));
    }
    public static void heapSort(int[] arr) {
        // Convert the array into a heap
        for (int i = arr.length / 2 - 1; i >= 0; i--) {
            heapify(arr, arr.length, i);
        }
        // Extract the maximum element from the heap and place it at the end of the array
        for (int i = arr.length - 1; i >= 0; i--) {
            int temp = arr[0];
            arr[0] = arr[i];
            arr[i] = temp;
            heapify(arr, i, 0);
        }
    }
    public static void heapify(int[] arr, int n, int i) {
        int largest = i;
        int left = 2 * i + 1;
        int right = 2 * i + 2;
        // Find the largest element among the root, left child, and right child
        if (left < n && arr[left] > arr[largest]) {
            largest = left;
        }
        if (right < n && arr[right] > arr[largest]) {
            largest = right;
        }
        // If the largest element is not the root, swap and heapify the sub-tree
        if (largest != i) {
            int temp = arr[i];
            arr[i] = arr[largest];
            arr[largest] = temp;
            heapify(arr, n, largest);
        }
    }
}
الناتج
Original Array:

5 9 3 1 8 6

Heap after insertion:

9 8 6 1 5 3

Heap after sorting:

1 3 5 6 8 9
فرز الكومة في Python مع Code مثال
def heap_sort(arr):
    """
    Sorts an array in ascending order using heap sort algorithm.
    Parameters:
        arr (list): The array to be sorted.
    Returns:
        list: The sorted array.
    """
    n = len(arr)
    # Build a max heap from the array
    for i in range(n // 2 - 1, -1, -1):
        heapify(arr, n, i)
    # Extract elements from the heap one by one
    for i in range(n - 1, 0, -1):
        arr[0], arr[i] = arr[i], arr[0]  # swap the root with the last element
        heapify(arr, i, 0)  # heapify the reduced heap
    return arr
def heapify(arr, n, i):
    """
    Heapifies a subtree with the root at index i in the given array.
    Parameters:
        arr (list): The array containing the subtree to be heapified.
        n (int): The size of the subtree.
        i (int): The root index of the subtree.
    """
    largest = i  # initialize largest as the root
    left = 2 * i + 1  # left child index
    right = 2 * i + 2  # right child index
    # If left child is larger than root
    if left < n and arr[left] > arr[largest]:
        largest = left
    # If right child is larger than largest so far
    if right < n and arr[right] > arr[largest]:
        largest = right
    # If largest is not root
    if largest != i:
        arr[i], arr[largest] = (
            arr[largest],
            arr[i],
        )  # swap the root with the largest element
        heapify(arr, n, largest)  # recursively heapify the affected subtree
arr = [4, 1, 3, 9, 7]
sorted_arr = heap_sort(arr)
print(sorted_arr)
الناتج
[1, 3, 4, 7, 9]
بعد ذلك، ستتعرف على طريقة التنصيف.
