
مثال على استخدام Hadoop MapReduce: أولاً Java البرنامج مع Code
 برافولا راناديفي
⚡ ملخص ذكي
تُكتب برامج Hadoop MapReduce على شكل ثلاثة Java الفئات، وأداة الربط، وأداة الاختزال، وأداة التشغيل، التي يتم تجميعها وتعبئتها في ملف jar وإرسالها إلى المجموعة لحساب المبيعات لكل دولة.
في هذا البرنامج التعليمي، سوف تتعلم كيفية استخدام Hadoop مع أمثلة MapReduce. بيانات الإدخال المستخدمة هي SalesJan2009.csvيحتوي هذا الملف على معلومات متعلقة بالمبيعات، مثل اسم المنتج وسعره وطريقة الدفع ومدينة العميل وبلده. والهدف هو معرفة عدد المنتجات المباعة في كل بلد.
أول برنامج Hadoop MapReduce
الآن في هذا البرنامج التعليمي MapReduce، سوف نقوم بإنشاء أول لدينا Java برنامج MapReduce:
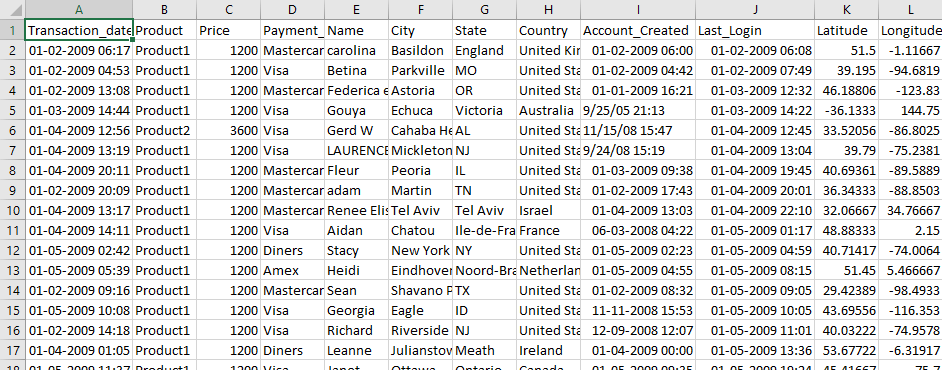
تُظهر لقطة الشاشة أدناه بيانات المبيعات الخام لشهر يناير 2009، حيث يمثل كل سطر معاملة واحدة ويقع البلد في العمود الثامن المفصول بفواصل.
تأكد من تثبيت Hadoop. قبل البدء بالعملية الفعلية، قم بتغيير المستخدم إلى 'hduser' (المعرف المستخدم أثناء تكوين Hadoop - يمكنك التبديل إلى معرف المستخدم المستخدم أثناء تكوين Hadoop الخاص بك).
su - hduser_
تتغير الرسالة إلى حساب المستخدم hduser، كما هو موضح أدناه.

الخطوة 1) إنشاء مجلد المشروع وملفات المصدر
قم بإنشاء دليل جديد باسم MapReduceTutorial كما هو موضح في مثال MapReduce أدناه.
sudo mkdir MapReduceTutorial

امنح الأذونات
sudo chmod -R 777 MapReduceTutorial

أنشئ الثلاثة Java الملفات المصدرية موجودة أدناه داخل برنامج MapReduceTutorial. لاحظ أن الثلاثة جميعها تستخدم الإصدار الأقدم. org.apache.hadoop.mapred واجهة برمجة التطبيقات (API)، التي لا تزال تأتي مع Hadoop 3.x.
SalesMapper.java
package SalesCountry;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesMapper extends MapReduceBase implements Mapper <LongWritable, Text, Text, IntWritable> {
	private final static IntWritable one = new IntWritable(1);

	public void map(LongWritable key, Text value, OutputCollector <Text, IntWritable> output, Reporter reporter) throws IOException {

		String valueString = value.toString();
		String[] SingleCountryData = valueString.split(",");
		output.collect(new Text(SingleCountryData[7]), one);
	}
}
SalesCountryReducer.java
package SalesCountry;

import java.io.IOException;
import java.util.*;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {

	public void reduce(Text t_key, Iterator<IntWritable> values, OutputCollector<Text,IntWritable> output, Reporter reporter) throws IOException {
		Text key = t_key;
		int frequencyForCountry = 0;
		while (values.hasNext()) {
			// replace type of value with the actual type of our value
			IntWritable value = (IntWritable) values.next();
			frequencyForCountry += value.get();

		}
		output.collect(key, new IntWritable(frequencyForCountry));
	}
}
SalesCountryDriver.java
package SalesCountry;

import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.*;
import org.apache.hadoop.mapred.*;

public class SalesCountryDriver {
    public static void main(String[] args) {
        JobClient my_client = new JobClient();
        // Create a configuration object for the job
        JobConf job_conf = new JobConf(SalesCountryDriver.class);

        // Set a name of the Job
        job_conf.setJobName("SalePerCountry");

        // Specify data type of output key and value
        job_conf.setOutputKeyClass(Text.class);
        job_conf.setOutputValueClass(IntWritable.class);

        // Specify names of Mapper and Reducer Class
        job_conf.setMapperClass(SalesCountry.SalesMapper.class);
        job_conf.setReducerClass(SalesCountry.SalesCountryReducer.class);

        // Specify formats of the data type of Input and output
        job_conf.setInputFormat(TextInputFormat.class);
        job_conf.setOutputFormat(TextOutputFormat.class);

        // Set input and output directories using command line arguments,
        //arg[0] = name of input directory on HDFS, and arg[1] =  name of output directory to be created to store the output file.

        FileInputFormat.setInputPaths(job_conf, new Path(args[0]));
        FileOutputFormat.setOutputPath(job_conf, new Path(args[1]));

        my_client.setConf(job_conf);
        try {
            // Run the job
            JobClient.runJob(job_conf);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
يتوسع الأرشيف إلى نفس ملفات المصدر الثلاثة، كما هو موضح هنا.
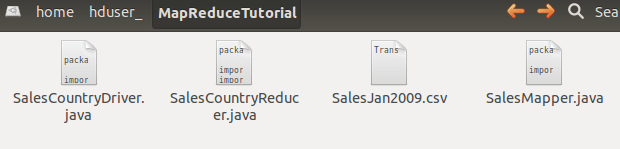
تحقق من أذونات الملف لجميع هذه الملفات

إذا كانت أذونات "القراءة" مفقودة، فامنحها:

الخطوة الثانية) تصدير مسار فئة Hadoop
قم بتصدير مسار الفئة كما هو موضح في مثال Hadoop أدناه.
export CLASSPATH="$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-core-2.2.0.jar:$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-common-2.2.0.jar:$HADOOP_HOME/share/hadoop/common/hadoop-common-2.2.0.jar:~/MapReduceTutorial/SalesCountry/*:$HADOOP_HOME/lib/*"
يتم عرض مسار الفئة المصدر مرة أخرى في موجه الأوامر.

الخطوة 3) تجميع Java ملفات
تجميع ملف Java الملفات (توجد هذه الملفات في الدليل Final-MapReduceHandsOn). سيتم وضع ملفات الفئات الخاصة بها في دليل الحزمة.
javac -d . SalesMapper.java SalesCountryReducer.java SalesCountryDriver.java
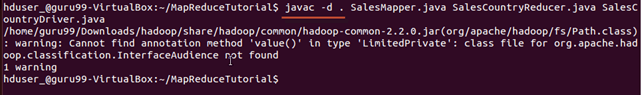
يمكن تجاهل هذا التحذير بأمان - فهو يشير فقط إلى أن واجهة برمجة تطبيقات mapred قد تم إيقافها.
سيؤدي هذا التجميع إلى إنشاء دليل في الدليل الحالي يحمل اسم الحزمة المحدد في Java ملف المصدر (أي SalesCountry في حالتنا) وضع جميع ملفات الفئات المترجمة فيه.

الخطوة الرابعة) إنشاء ملف البيان
أنشئ ملفًا جديدًا باسم Manifest.txt
sudo gedit Manifest.txt
أضف السطر التالي إليه:
Main-Class: SalesCountry.SalesCountryDriver

SalesCountry.SalesCountryDriver هو اسم الفئة الرئيسية. يُرجى ملاحظة أنه يجب عليك الضغط على مفتاح الإدخال في نهاية هذا السطر.
الخطوة 5) قم بتجميع الفئات في ملف جافا
قم بإنشاء ملف Jar
jar cfm ProductSalePerCountry.jar Manifest.txt SalesCountry/*.class

تأكد من إنشاء ملف الجرة

الخطوة 6) ابدأ تشغيل هادوب
ابدأ هادوب
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
الخطوة 7) انسخ ملف الإدخال إلى نظام ملفات Hadoop الموزع (HDFS)
انسخ الملف SalesJan2009.csv إلى ~/inputMapReduce
الآن استخدم الأمر أدناه لنسخ ~/inputMapReduce إلى HDFS.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/inputMapReduce /
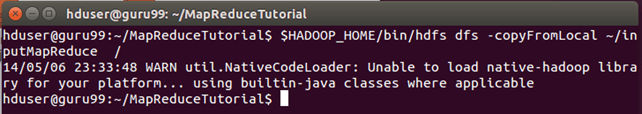
يمكننا تجاهل هذا التحذير بأمان.
التحقق مما إذا كان الملف قد تم نسخه بالفعل أم لا.
$HADOOP_HOME/bin/hdfs dfs -ls /inputMapReduce

الخطوة 8) تشغيل مهمة MapReduce
قم بتشغيل مهمة MapReduce
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales

سيؤدي هذا إلى إنشاء دليل إخراج باسم Mapreduce_output_sales on HDFS. ستكون محتويات هذا الدليل عبارة عن ملف يحتوي على مبيعات المنتجات لكل بلد.
الخطوة 9) اقرأ النتائج
يمكن رؤية النتيجة من خلال واجهة الأوامر على النحو التالي:
$HADOOP_HOME/bin/hdfs dfs -cat /mapreduce_output_sales/part-00000
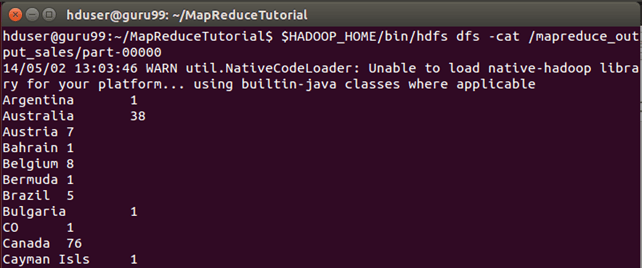
يمكن أيضًا رؤية النتائج عبر واجهة الويب كما يلي:
ساعات العمل http://localhost:50070/ في متصفح الويب. في Hadoop 3.x، تم نقل واجهة مستخدم الويب الخاصة بـ NameNode إلى المنفذ 9870، لذا استخدم http://localhost:9870/ هناك بدلا من ذلك.

الآن، حدد "استعراض نظام الملفات" وانتقل إلى /mapreduce_output_sales

افتح الجزء-ر-00000

شرح فئة SalesMapper
مع استمرار العمل من البداية إلى النهاية، تشرح الأقسام الثلاثة التالية ما تفعله كل فئة فعليًا.
في هذا القسم، سنفهم كيفية تنفيذ فئة SalesMapper.
١. نبدأ بتحديد اسم حزمة لفئتنا. اسم هذه الحزمة هو SalesCountry. يُرجى ملاحظة أن ناتج عملية التجميع، SalesMapper.class، سيُحفظ في مجلد يحمل اسم هذه الحزمة: SalesCountry.
وبعد ذلك، نقوم باستيراد حزم المكتبة.
تُظهر اللقطة أدناه تطبيقًا لفئة SalesMapper-

عينة Code التفسير:
1. تعريف فئة SalesMapper-
public class SalesMapper extends MapReduceBase implements Mapper<LongWritable, Text, Text, IntWritable> {
يجب أن يتم توسيع كل فئة من فئات Mapper من فئة MapReduceBase ويجب أن تنفذ واجهة Mapper.
2. تحديد وظيفة "الخريطة"-
public void map(LongWritable key,
         Text value,
OutputCollector<Text, IntWritable> output,
Reporter reporter) throws IOException
الجزء الرئيسي من فئة Mapper هو طريقة 'map()' التي تقبل أربعة وسائط.
في كل استدعاء لطريقة 'map()'، يتم تمرير زوج من المفتاح والقيمة ('key' و'value' في هذا الكود).
تبدأ دالة 'map()' بتقسيم النص المدخل الذي يتم استقباله كوسيط. وتقوم بتقسيم كل سطر إلى حقول.
String valueString = value.toString();
String[] SingleCountryData = valueString.split(",");
هنا، تُستخدم الفاصلة (,) كفاصل.
بعد ذلك، يتم تكوين زوج باستخدام سجل في الفهرس السابع من المصفوفة 'SingleCountryData' وقيمة '1'.
output.collect(new Text(SingleCountryData[7]), one);
نختار السجل في الفهرس السابع لأننا نحتاج إلى بيانات البلد وهي موجودة في الفهرس السابع في المصفوفة 'SingleCountryData'.
يرجى ملاحظة أن بيانات الإدخال لدينا بالصيغة التالية (حيث يكون البلد في الفهرس السابع، مع اعتبار 0 فهرس البداية)-
Transaction_date,Product,Price,Payment_Type,Name,City,State,Country,Account_Created,Last_Login,Latitude,Longitude
إن مخرجات أداة الربط هي مرة أخرى عبارة عن زوج من المفتاح والقيمة يتم إصداره باستخدام طريقة 'collect()' الخاصة بـ 'OutputCollector'.
شرح فئة SalesCountryReducer
في هذا القسم، سنفهم كيفية تنفيذ فئة SalesCountryReducer.
١. نبدأ بتحديد اسم الحزمة الخاصة بفئتنا. اسم الحزمة هو SalesCountry. يُرجى ملاحظة أن ناتج عملية التجميع، SalesCountryReducer.class، سيُحفظ في مجلد يحمل اسم هذه الحزمة: SalesCountry.
وبعد ذلك، نقوم باستيراد حزم المكتبة.
تُظهر اللقطة أدناه تطبيقًا لفئة SalesCountryReducer-
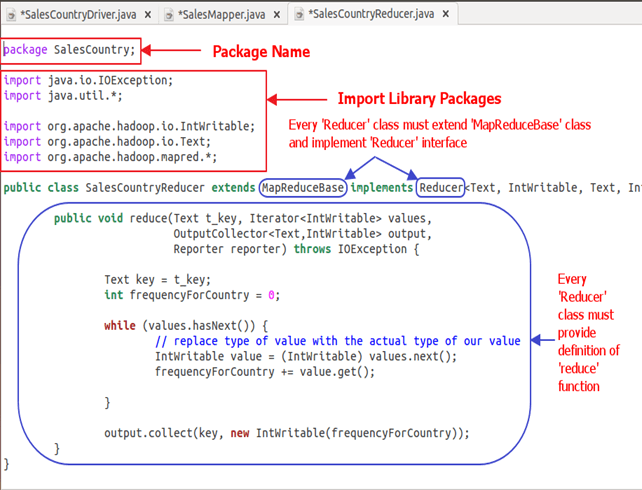
Code التفسير:
1. تعريف فئة SalesCountryReducer-
public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {
هنا، يمثل النوعان الأولان من البيانات، 'Text' و 'IntWritable'، نوع بيانات مفتاح-قيمة الإدخال إلى المُختزل.
يكون ناتج برنامج الخرائط على شكل ، تُصبح مخرجات المُعالج مدخلاتٍ للمُختزل. لذا، وللتوافق مع نوع البيانات، يُستخدم كلٌ من Text و IntWritable كنوع بيانات هنا.
أما النوعان الأخيران من البيانات، 'Text' و 'IntWritable'، فهما نوع البيانات الناتج عن المُختزل في شكل زوج من المفتاح والقيمة.
يجب أن يتم توسيع كل فئة مختزلة من فئة MapReduceBase ويجب أن تنفذ واجهة Reducer.
2. تحديد وظيفة "التقليل"-
public void reduce( Text t_key,
             Iterator<IntWritable> values,
             OutputCollector<Text,IntWritable> output,
             Reporter reporter) throws IOException {
المدخلات إلى طريقة reduce() هي مفتاح يحتوي على قائمة من القيم المتعددة.
على سبيل المثال، في حالتنا، سيكون -
, , , , , .
يتم إعطاء هذا للمخفض على النحو التالي:
لذا، لقبول الوسائط من هذا الشكل، يتم استخدام نوعي البيانات الأولين، وهما: النص والمكرر. النص هو نوع بيانات يتكون من مفتاح ومكرر. هو نوع بيانات لقائمة القيم الخاصة بهذا المفتاح.
الوسيط التالي من نوع OutputCollector والتي تجمع مخرجات مرحلة التخفيض.
تبدأ دالة reduce() بنسخ قيمة المفتاح وتهيئة عداد التكرار إلى 0.
Text key = t_key;int frequencyForCountry = 0;
ثم، باستخدام حلقة "while"، نكرر قائمة القيم المرتبطة بالمفتاح ونحسب التردد النهائي عن طريق جمع كل القيم.
 while (values.hasNext()) {
            // replace type of value with the actual type of our value
            IntWritable value = (IntWritable) values.next();
            frequencyForCountry += value.get();

        }
الآن، نقوم بدفع النتيجة إلى جامع الإخراج على شكل مفتاح وعدد الترددات التي تم الحصول عليها.
الكود أدناه يفعل هذا-
output.collect(key, new IntWritable(frequencyForCountry));
شرح فئة SalesCountryDriver
في هذا القسم، سنفهم كيفية تنفيذ فئة SalesCountryDriver.
١. نبدأ بتحديد اسم حزمة لفئتنا. اسم هذه الحزمة هو SalesCountry. يُرجى ملاحظة أن ناتج عملية التجميع، SalesCountryDriver.class، سيُحفظ في مجلد يحمل اسم هذه الحزمة: SalesCountry.
فيما يلي سطر يحدد اسم الحزمة متبوعًا برمز لاستيراد حزم المكتبة.

2. حدد فئة برنامج التشغيل التي ستقوم بإنشاء مهمة عميل جديدة وكائن التكوين والإعلان عن فئات Mapper وReducer.
فئة برنامج التشغيل مسؤولة عن إعداد وظيفة MapReduce الخاصة بنا ليتم تشغيلها Hadoopفي هذه الفئة، نحدد اسم المهمة ونوع بيانات الإدخال/الإخراج وأسماء فئات المابير والمخفض.

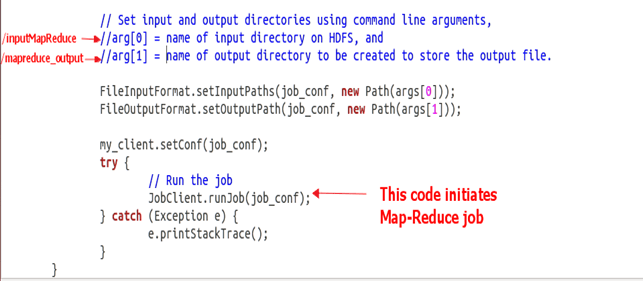
3. في مقتطف الكود أدناه، قمنا بتعيين أدلة الإدخال والإخراج التي يتم استخدامها لاستهلاك مجموعة بيانات الإدخال وإنتاج المخرجات، على التوالي.
arg[0] و arg[1] هما وسيطات سطر الأوامر التي يتم تمريرها مع الأمر المُعطى في تطبيق MapReduce العملي، أي
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales
4. تفعيل مهمتنا
يبدأ الكود التالي تنفيذ مهمة MapReduce-
try {
    // Run the job
    JobClient.runJob(job_conf);
} catch (Exception e) {
    e.printStackTrace();
}
